Contexto de prioridad
El contexto de prioridad le permite determinar qué parámetro de entrada de una función establece el contexto actual durante la ejecución de la asignación. En función de la estructura de la asignación, puede establecer un contexto de prioridad para modificar el orden en el que se procesan los valores e influir en qué datos de origen permanecen disponibles en el contexto actual.
Para establecer el contexto de prioridad de una función, haga clic con el botón derecho en un conector de entrada de la función y seleccione Contexto de prioridad en el menú contextual. El conector de entrada designado como contexto de prioridad aparece rodeado por un círculo.
Caso 1: Control del orden de las combinaciones generadas (secuencias)
Cuando varias entradas de la función reciben secuencias, el contexto de prioridad determina el orden en el que se generan las combinaciones de salida.
Procesamiento sin contexto de prioridad
En la asignación siguiente, la función concat recibe dos entradas. Cada entrada de la función es una secuencia generada por la función generate-sequence. Si las secuencias están conectadas a más de una entrada de la función, la asignación genera el producto cartesiano de las secuencias de entrada.
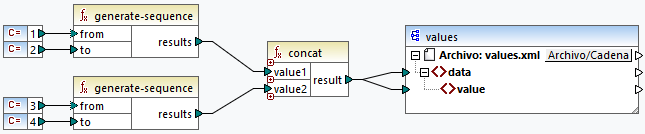
De forma predeterminada, MapForce procesa la primera entrada de la función antes que la segunda. Como resultado, MapForce combina los valores de la siguiente manera:
<data> |
Procesamiento sin contexto de prioridad
La asignación que figura a continuación muestra que se ha establecido el contexto de prioridad en el segundo conector de entrada de la función concat. Esto significa que MapForce procesa primero la segunda secuencia de entrada.
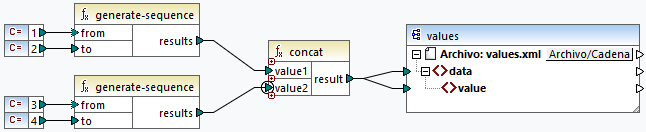
Por lo tanto, los cambios en el contexto de prioridad solo modifican el orden en el que se generan las combinaciones. No modifica las combinaciones en sí mismas. Este sería el resultado:
<data> |
Caso 2: Control del contexto actual al combinar datos procedentes de múltiples orígenes
El objetivo de la siguiente asignación es copiar datos de Articles.xml en un archivo XML nuevo con un esquema distinto, articledata.xml. La asignación busca los detalles de cada artículo en el archivo Products.xml y los combina con el registro de archivo correspondiente.
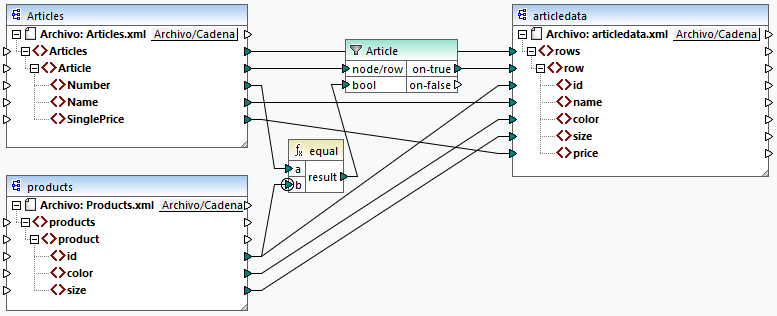
A continuación se muestra el contenido de los archivos Articles.xml y Products.xml.
<Articles> <Number>1</Number> <Name>T-Shirt</Name> <SinglePrice>25</SinglePrice> </Article> <Article> <Number>2</Number> <Name>Socks</Name> <SinglePrice>2.30</SinglePrice> </Article> <Article> <Number>3</Number> <Name>Jacket</Name> <SinglePrice>57.50</SinglePrice> </Article> |
Articles.xml
<products> <id>1</id> <color>red</color> <size>10</size> </product> <product> <id>2</id> <color>blue</color> <size>20</size> </product> |
Products.xml
Cada registro de Articles.xml tiene un Number, y cada registro de Products.xml tiene un id. La función equal comprueba si el número del artículo y el identificador del producto coinciden. El resultado se suministra como entrada para el filtro. Si el resultado es true, los valores de los elementos Name, SinglePrice, id, color y size se copian en el destino.
El contexto de prioridadse ha definido en el segundo parámetro de entrada de la función equal. Esto se traduce en la siguiente lógica de asignación:
•Para cada producto, MapForce establece el producto actual como contexto para la función equal.
•Dado que se da prioridad a los datos proporcionados en el archivo Products.xml, se crea un nuevo row de destino para cada product que cumpla la condición de filtro.
•Para cada Article,, MapForce evalúa la función equal en el contexto del producto actual. Si la condición del filtro tiene valor true, los detalles del artículo y del producto correspondientes se asignan al destino.
•Dado que los elementos Articles y rows están conectados, la asignación rastrea dicha conexión hasta un artículo concreto en cada iteración y copia únicamente los datos de dicho artículo al destino.
Este sería el resultado:
<rows> <row> |
Sin contexto de prioridad
Si no se establece el contexto de prioridad en la función equal, MapForce procesa la asignación de la siguiente manera:
•Para cada Article, MapForce establece el artículo actual como contexto para la función equal.
•Cada product se evalua en el contexto del Article actual.
•El filtro compara el Article actual con cada product. Si la condición del filtro tiene valor true, se crea un row de destino.
•Dado que el elemento product no está conectado a ningún nodo de destino, MapForce no puede leer los detalles de un producto concreto y, en su lugar, incorpora cada producto al contexto actual. En consecuencia, cada fila de destino contiene los elementos id, size y color de todos los productos (en Products.xml) que cumplen la condición del filtro.
Este sería el resultado:
<rows> <row> |
Utilizar una variable en lugar del contexto de prioridad
En lugar de utilizar el contexto de prioridad, puede emplear una variable intermedia (el componente con el nodo compute-when que aparece a continuación) para incluir en el mismo contexto cada artículo y producto que cumpla la condición del filtro. Las variables le permiten almacenar datos de forma temporal y modificar el contexto según sea necesario.
Hemos modificado nuestra asignación añadiendo una variable que tiene el mismo esquema que el componente de destino (imagen siguiente).
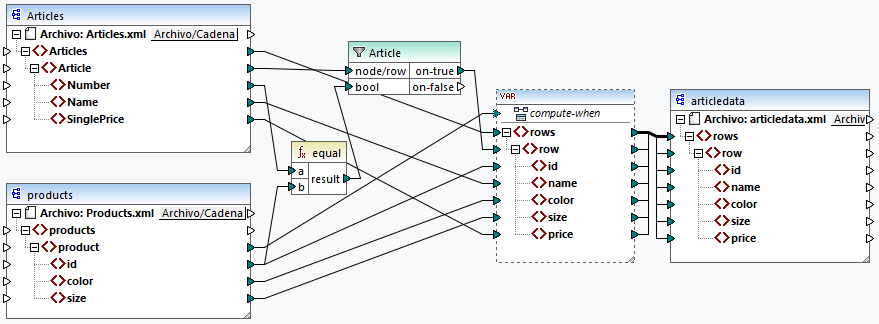
La lógica de la asignación modificada es la siguiente:
•La ejecución se inicia el en el nodo raíz de destino.
•Antes de copiar datos al destino, la asignación recopila datos en la variable.
•La conexión entre el elemento product y el nodo compute-when hace que la variable se calcule en el contexto de cada product.
•De este modo, la condición del filtro se comprueba en el contexto de cada product. Si la condición tiene valor true, la variable se rellena con los datos correspondientes de ambos archivos de origen. A continuación, estos datos se pasan al destino.