Prioritätskontext
Mit Hilfe des Prioritätskontexts können Sie beeinflussen, welcher Input einer Funktion den aktuellen Kontext bei der Mapping-Ausführung darstellt. Je nach Mapping-Struktur können Sie einen Prioritätskontext definieren, um die Reihenfolge, in der Werte verarbeitet werden, zu ändern und festzulegen, welche Quelldaten im aktuellen Kontext verfügbar bleiben.
Um für eine Funktion einen Prioritätskontext zu definieren, klicken Sie mit der rechten Maustaste auf einen Input-Konnektor der Funktion und wählen Sie im Kontextmenü den Befehl Prioritätskontext. Der als Prioritätskontext festgelegte Input-Konnektor wird mit einem Kreis umrandet.
Fall 1: Festlegen der Reihenfolge von generierten Kombinationen (Sequenzen)
Wenn mehrere Funktions-Inputs Sequenzen erhalten, legt der Prioritätskontext fest, in welcher Reihenfolge die Ausgabekombinationen generiert werden.
Verarbeitung ohne Prioritätskontext
Die concat-Funktion im unten gezeigten Mapping erhält zwei Inputs. Jeder Funktions-Input ist eine durch die Funktion generate-sequence generierte Sequenz. Wenn Sequenzen mit mehr als einem Funktions-Input verbunden werden, generiert das Mapping das kartesische Produkt der Input-Sequenzen.
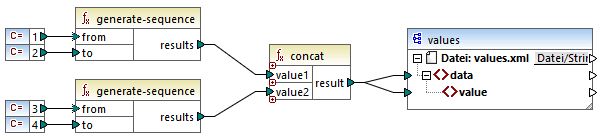
MapForce verarbeitet standardmäßig den ersten Funktions-Input vor dem zweiten. Als Ergebnis kombiniert MapForce die Werte folgendermaßen:
<data> |
Verarbeitung ohne Prioritätskontext
Im unten gezeigten Mapping sehen Sie, dass der zweite Input-Konnektor der concat-Funktion als Prioritätskontext festgelegt wurde. Das bedeutet, dass MapForc die zweite Input-Sequenz zuerst verarbeitet.
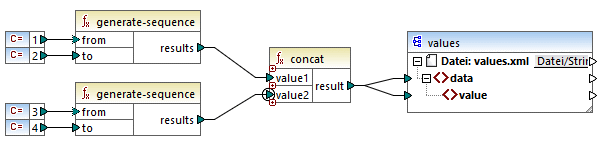
Der Prioritätskontext ändert somit nur die Reihenfolge, in der die Kombinationen generiert werden. Die Kombinationen selbst werden dadurch nicht geändert. Unten sehen Sie die Ausgabe.
<data> |
Fall 2: Festlegen des aktuellen Kontexts beim Kombinieren von Daten aus mehreren Quellen
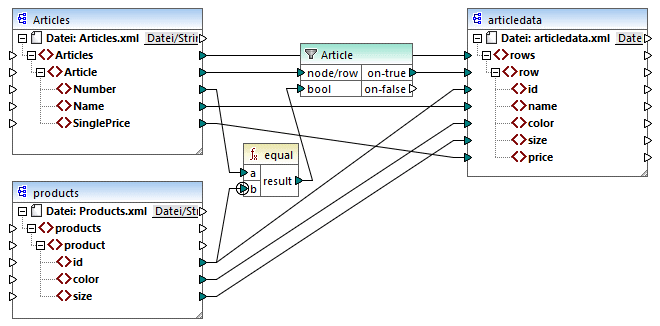
Ziel des unten gezeigten Mappings ist es, Daten aus Articles.xml in eine neue XML-Datei mit einem anderen Schema, nämlich articledata.xml, zu kopieren. Im Mapping werden die Informationen zu jedem Artikel (Article) in der Datei Products.xml abgerufen und auf den entsprechenden Artikeldatensatz gemappt.
Nachfolgend sehen Sie den Inhalt von Articles.xml und Products.xml.
<Articles> <Number>1</Number> <Name>T-Shirt</Name> <SinglePrice>25</SinglePrice> </Article> <Article> <Number>2</Number> <Name>Socks</Name> <SinglePrice>2.30</SinglePrice> </Article> <Article> <Number>3</Number> <Name>Jacket</Name> <SinglePrice>57.50</SinglePrice> </Article> |
Articles.xml
<products> <id>1</id> <color>red</color> <size>10</size> </product> <product> <id>2</id> <color>blue</color> <size>20</size> </product> |
Products.xml
Jeder Datensatz in Articles.xml hat eine Nummer (Number) und jeder Datensatz in Products.xml hat ein Element id. Mit der equal-Funktion wird überprüft, ob die Artikelnummer und die Produkt-ID identisch sind. Das Ergebnis wird anschließend als Input für den Filter bereitgestellt. Bei true werden die Werte der Elemente Name, SinglePrice, id, color und size in die Zielkomponente kopiert.
Als Prioritätskontext wurde der zweite Input-Parameter der equal-Funktion definiert. Dies wird in die folgende Mapping-Logik übersetzt:
•MapForce ermittelt für jedes product-Element das aktuelle Produkt als Kontext für die equal-Funktion.
•Da die Daten aus der Datei Products.xml die Priorität erhalten, wird für jedes product-Element, das der Filterbedingung entspricht, ein neues row-Zielelement erstellt.
•MapForce wertet für jedes Article-Element die equal-Funktion im aktuellen Produktkontext aus. Wenn die Filterbedingung true ergibt, werden der entsprechende Artikel und seine Produktinformationen auf die Zielkomponente gemappt.
•Da die Elemente Articles und rows verbunden sind, verfolgt das Mapping die Verbindung mit jeder Iteration zurück zu einem bestimmten Artikel und kopiert die Informationen nur dieses Artikels in die Zielkomponente.
Unten sehen Sie die Ausgabe.
<rows> <rows> |
Kein Prioritätskontext
Wenn für die equal-Funktion kein Prioritätskontext definiert wird, verarbeitet MapForce das Mapping folgendermaßen:
•MapForce ermittelt für jedes Article-Element den aktuellen Artikel als Kontext für die equal-Funktion.
•Jedes product-Element wird im Kontext des aktuellen Article-Elements ausgewertet.
•Der Filter vergleicht das aktuelle Article-Element mit den einzelnen product-Elementen. Wenn die Filterbedingung true ergibt, wird ein row-Zieldatenelement erzeugt.
•Da das product-Element nicht mit einem Ziel-Node verbunden ist, kann MapForce die Informationen eines bestimmten Produkts nicht lesen und bringt statt dessen jedes Produkt in den aktuellen Kontext. Infolgedessen enthält jedes row-Zielelement die Elemente id, size und color aller Produkte (in Products.xml), die der Filterbedingung entsprechen.
Unten sehen Sie die Ausgabe:
<rows> <row> |
Verwendung einer Variablen anstelle eines Prioritätskontexts
Anstelle eines Prioritätskontexts können Sie eine Zwischenvariable verwenden (in der Abbildung unten die Komponente mit dem compute-when-Node), um jeden Artikel und jedes Produkt, das der Filterbedingung entspricht, in denselben Kontext zu bringen. Mit Hilfe von Variablen können Sie Daten vorübergehend speichern und den Kontext bei Bedarf ändern.
Wir haben unser Mapping geändert, indem wir eine Variable hinzugefügt haben, die dasselbe Schema wie die Zielkomponente hat (siehe Abbildung unten).
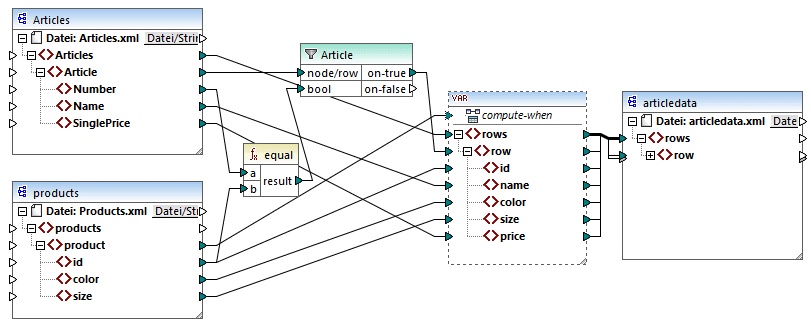
Die Logik des geänderten Mappings ist die folgende:
•Die Ausführung beginnt beim Root-Node der Zielkomponente.
•Bevor Daten in die Zielkomponente kopiert werden, werden die Daten in der Variablen gesammelt.
•Aufgrund der Verbindung zwischen dem Element product und dem Node compute-when wird die Variable im Kontext jedes einzelnen product-Elements berechnet.
•Die Filterbedingung wird daher im Kontext jedes einzelnen product-Elements überprüft. Wenn die Bedingung true ergibt, wird die Variable mit den entsprechenden Daten aus beiden Quelldateien befüllt. Anschließend werden diese Daten an die Zielkomponente übergeben.