Le transfert de données d’une base de données vers une autre est l’une des tâches les plus courantes en gestion des données, que ce soit pour consolider des systèmes après une fusion, mettre hors service une plateforme héritée, standardiser l’utilisation d’un seul fournisseur de bases de données ou transférer une base de données de bureau vers une base de données serveur. Altova MapForce est un outil de migration de bases de données qui gère ces conversions via une interface visuelle de type glisser-déposer, sans qu’il soit nécessaire d’écrire manuellement des scripts de migration.
MapForce se connecte à vos bases de données source et cible, lit automatiquement les deux schémas et vous permet de définir les règles de migration en traçant des connexions entre les tables et les colonnes de chaque côté. Comme la source et la cible sont mappées explicitement, vous n’êtes pas limité à des schémas identiques : vous pouvez renommer des colonnes, diviser ou fusionner des champs, convertir des types de données, filtrer des lignes et remodeler la structure cible dans le cadre d’une même migration.
Bases de données relationnelles prises en charge :
Bases de données NoSQL prises en charge :
Toute base de données prise en charge peut servir de source, de cible, ou les deux. Cela signifie que ce même outil couvre toutes les combinaisons source-cible de la liste ci-dessus, plutôt que de proposer un seul chemin de migration fixe.
Il est facile de définir un projet de migration de base de données à l’aide des outils visuels de mappage de données par glisser-déposer de MapForce. Vous pouvez même commencer par utiliser Altova AI pour obtenir des suggestions de connexions après avoir chargé vos structures source et cible.
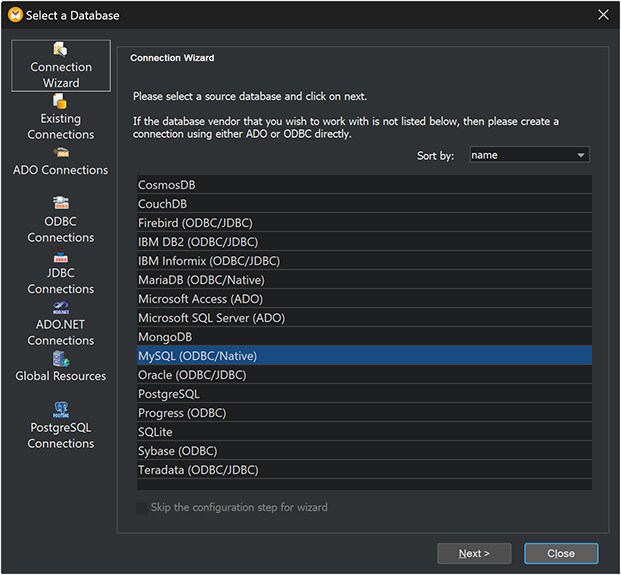
1. Se connecter à la base de données source. L'assistant de connexion à la base de données vous guide tout au long de la procédure de connexion. Les connexions SQLite sont prises en charge en tant que connexions natives et directes au fichier de base de données, sans nécessiter de pilotes distincts. Les autres bases de données se connectent de manière native ou via des interfaces standard, notamment ODBC, JDBC, ADO et ADO.NET.
2. Se connecter à la base de données cible. MapForce charge le schéma cible de la même manière et affiche les tables, vues et relations disponibles.
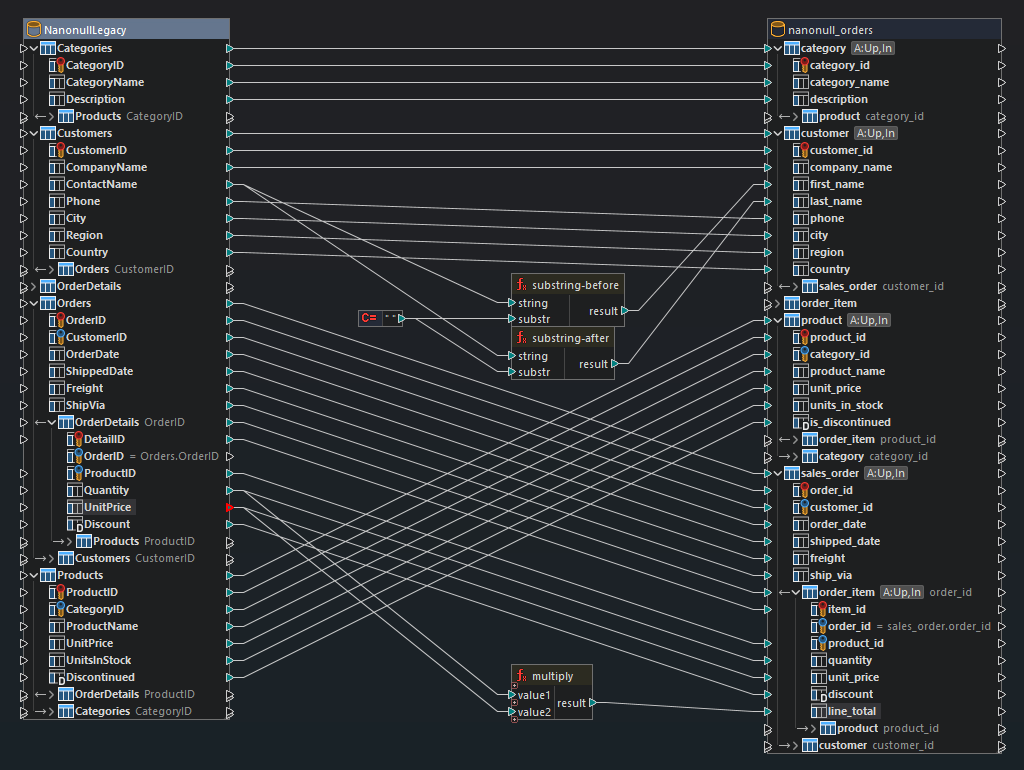
3. Mapper les tables et les colonnes. Faites glisser des lignes de connexion de la source vers la cible, ou commencez par utiliser Altova AI. MapForce reconnaît automatiquement les relations entre les tables ; ainsi, les tables liées conservent leur structure dans le mappage.
4. Transformer les données selon les besoins. Insérez des filtres, des conditions et des fonctions de traitement des données entre la source et la cible pour convertir les types, reformater les valeurs, concaténer ou diviser des champs, et exclure les lignes que vous ne souhaitez pas migrer.
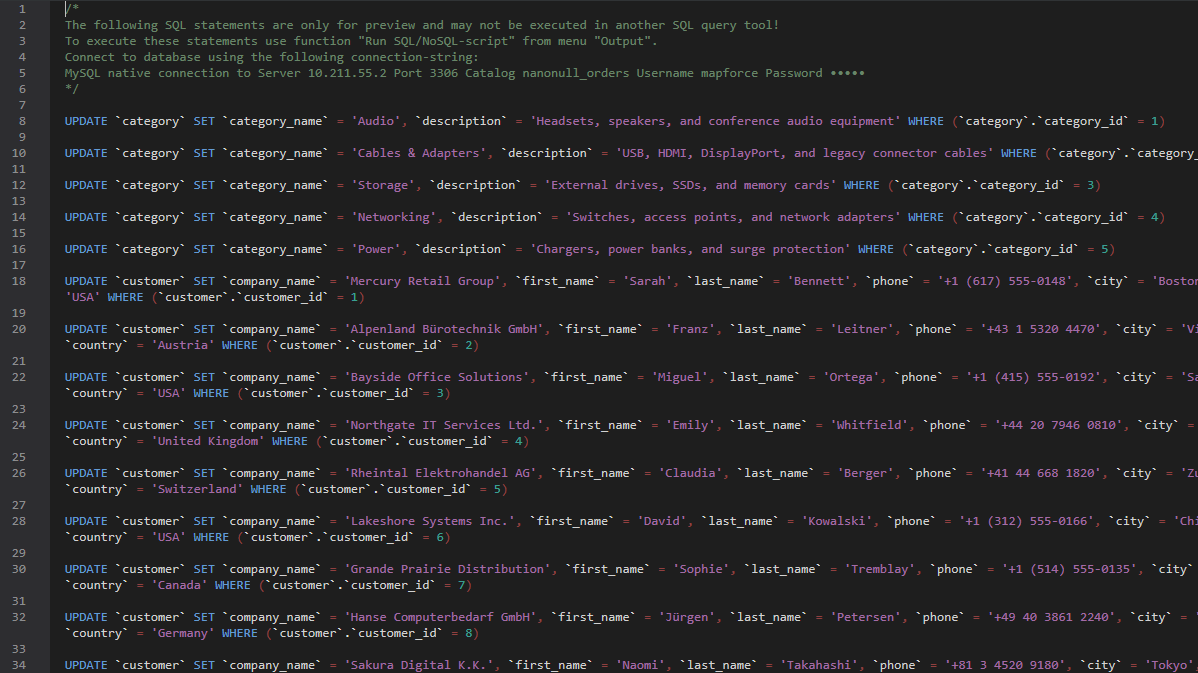
5. Prévisualisez et exécutez. Le moteur MapForce intégré vous permet de prévisualiser les scripts SQL — instructions SELECT, INSERT, UPDATE et DELETE — dans l’onglet Sortie avant de les exécuter sur la base de données cible.
Plusieurs des tâches de migration de base de données à base de données les plus couramment requises sont décrites ci-dessous. La même approche s’applique à toute autre combinaison de bases de données prises en charge.
Les entreprises qui migrent d’Oracle vers PostgreSQL doivent transférer les données des tables entre deux moteurs qui nomment et classent leurs colonnes différemment. À l’aide de l’assistant de connexion à la base de données, MapForce se connecte à Oracle via JDBC ou ODBC et à PostgreSQL via une connexion native ou une connexion basée sur un pilote. Il charge les deux schémas dans le volet de mappage, où vous pouvez utiliser le glisser-déposer (ou invoquer Altova AI) pour relier les tables Oracle à leurs équivalents PostgreSQL.
Il est tout aussi simple de glisser-déposer des fonctions de traitement des données pour convertir les valeurs entre les types de données Oracle et PostgreSQL, reformater les dates et les horodatages, et gérer les valeurs NULL de manière adaptée, conformément aux règles des bases de données concernées. Les paramètres de clés de base de données vous permettent de choisir si les valeurs des clés primaires et étrangères proviennent de la source Oracle ou sont générées par PostgreSQL lors de l’insertion.
La migration de MySQL vers PostgreSQL est l’une des conversions les plus courantes pour lesquelles MapForce est utilisé. Une fois les deux structures de base de données chargées, MapForce interprète chaque schéma, affiche les tables et les vues disponibles, et identifie les relations entre elles. Pour finaliser la migration, il suffit de tracer des lignes de connexion entre les structures source et cible, puis d’ajouter des fonctions de traitement des données chaque fois que les types ou les conventions de MySQL et de PostgreSQL divergent.
Le mappage étant enregistré sous forme de conception réutilisable, la même migration de MySQL vers PostgreSQL peut être réexécutée chaque fois que les données source changent, par exemple lors d’une migration progressive ou dans le cadre d’un chargement récurrent.
Les bases de données SQLite sont fréquemment utilisées pour le stockage local ou intégré et doivent ensuite être transférées vers un serveur MySQL partagé.
Le typage flexible de SQLite est l’élément principal à prendre en compte dans cette migration : les valeurs stockées de manière non stricte par SQLite doivent être mappées vers des colonnes MySQL à typage explicite. Les fonctions de traitement des données de MapForce effectuent cette conversion au sein même du mappage, de sorte que des valeurs correctement typées soient écrites dans la cible MySQL.
Lors d’une migration de MSSQL vers MySQL, MapForce gère les différences de schéma entre les deux moteurs dans le cadre du mappage : le renommage des colonnes, la conversion des types et le formatage des valeurs s’effectuent tous de manière graphique plutôt que via des scripts de migration. Les actions sur les tables vous permettent de contrôler la manière dont les données sont mappées. Vous pouvez choisir INSERT, UPDATE ou DELETE pour chaque table, et définir les colonnes que MapForce utilise pour déterminer si une ligne cible existe déjà.
Les bases de données Access qui ont dépassé les capacités d’un ordinateur de bureau sont généralement migrées vers SQL Server. MapForce se connecte à Microsoft Access et à SQL Server via ADO, charge les deux schémas et vous permet de mapper les tables et les requêtes Access vers des tables SQL Server.
Access et SQL Server diffèrent en termes de types de données, de gestion des clés et de règles de nommage. Le mappage visuel de la conversion met en évidence ces différences et vous permet de les corriger une seule fois, au niveau du mappage, plutôt que de manière répétée dans les données. Les paramètres de clé de la base de données déterminent si les valeurs AutoNumber d’Access sont conservées ou remplacées par des valeurs d’identité de SQL Server.
La conversion d’un fichier ACCDB vers SQLite permet de transférer une base de données Access vers un format léger, basé sur des fichiers, qui s’exécute partout. MapForce lit la base de données Access via ADO et écrit dans le fichier SQLite via une connexion native. Comme pour toute migration MapForce, les schémas source et cible n’ont pas besoin de correspondre. Vous pouvez aplatir, renommer ou créer un sous-ensemble de la structure Access lors de sa transformation vers SQLite.
MariaDB et MySQL sont étroitement liés, mais une migration entre ces deux systèmes nécessite tout de même de prendre en compte les types de données, les clés et toute divergence dans les définitions de colonnes. Lorsque les schémas sont identiques, le mappage consiste en un simple ensemble de connexions ; lorsqu’ils diffèrent, les mêmes filtres et fonctions que ceux utilisés dans tout autre chemin de migration s’appliquent.
MapForce migre également les données depuis des bases de données relationnelles vers des bases de données NoSQL, notamment MongoDB, CouchDB et Microsoft Azure Cosmos DB. Les lignes relationnelles et leurs tables associées sont mappées visuellement en structures de documents ; ainsi, un schéma SQL normalisé peut être transformé en documents dans le cadre de la migration même, plutôt que lors d’une étape de transformation distincte.
La plupart des migrations réelles ne consistent pas en un simple mappage colonne par colonne. MapForce intègre une bibliothèque de fonctions de traitement des données permettant d’effectuer des comparaisons logiques, des calculs mathématiques, des manipulations de chaînes de caractères et la gestion des dates et heures, ainsi que des filtres et des conditions qui déterminent quelles lignes parviennent à la base de données cible.
Cela signifie que vous pouvez migrer un sous-ensemble des données source, fusionner deux colonnes source en une seule colonne cible, répartir une seule colonne source sur plusieurs colonnes cibles, rechercher et remplacer des valeurs, ou appliquer des règles métier pendant la migration, le tout au sein d’un même mappage visuel.
Paramètres des clés de base de données
Les paramètres de clés de base de données de MapForce vous permettent de personnaliser la manière dont les valeurs des clés primaires et étrangères sont ajoutées à la base de données cible lors d’une migration. Vous pouvez fournir des valeurs de clé depuis MapForce, en conservant les identifiants utilisés dans le système source, ou laisser le système de base de données cible se charger de la génération automatique des valeurs.
Définir les actions sur les tables de base de données
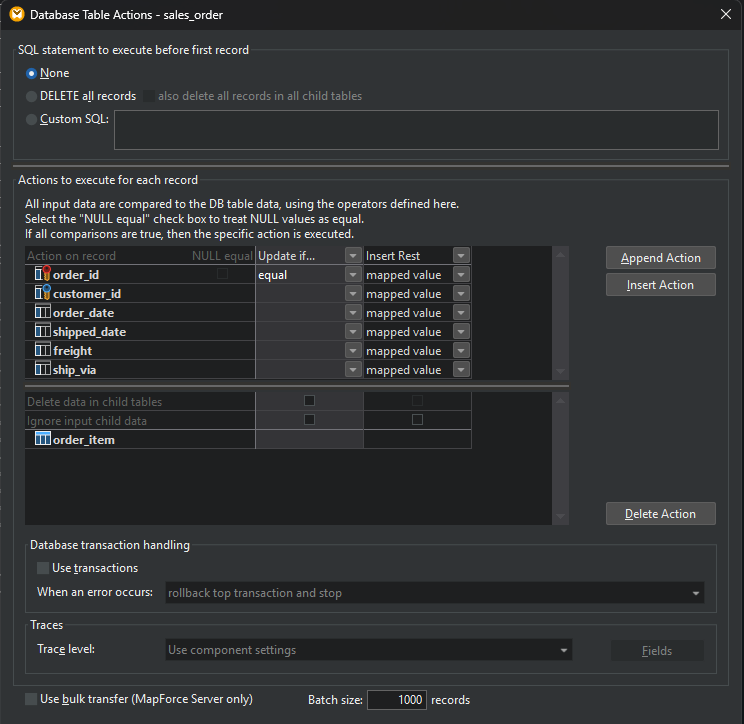
Le dialogue Actions de table de base de données contrôle la manière dont les données sont écrites dans chaque table cible. Sélectionnez l’action (INSERT, UPDATE, DELETE) à exécuter et définissez les colonnes que MapForce utilise pour faire correspondre les enregistrements cibles. Ce dialogue prend en charge la comparaison des valeurs NULL ; une migration peut ainsi être configurée pour comparer les données en tenant compte des valeurs NULL, conformément aux règles de la base de données concernée.
Prise en charge des procédures stockées SQL
MapForce prend en charge les procédures stockées en tant que composants d’entrée ou de sortie, ou sous forme d’appels de type fonction — en fournissant des données d’entrée, en exécutant la procédure et en mappant les données de sortie vers d’autres composants. Les procédures stockées peuvent également être utilisées pour générer des valeurs de clé au cours d’une migration.
Journalisation/traçage des sorties de base de données
Le traçage des sorties de base de données consigne toutes les modifications apportées par une migration lors de son exécution. Lorsque le traçage est activé, les événements tels que les actions d’insertion ou de mise à jour dans la base de données, ainsi que les erreurs, sont consignés dans un fichier XML que vous pouvez analyser ultérieurement ou traiter davantage. La journalisation des sorties est utile pour établir un relevé de ce qui a été migré.
Gestion des erreurs de transaction de base de données
MapForce propose une gestion des transactions de base de données permettant d’annuler la partie affectée d’une conversion de base de données lorsqu’une erreur est levée, et, si vous le souhaitez, de poursuivre le reste du mappage. Cela évite qu’un échec partiel ne laisse la base de données cible dans un état incohérent.
Interroger directement les bases de données
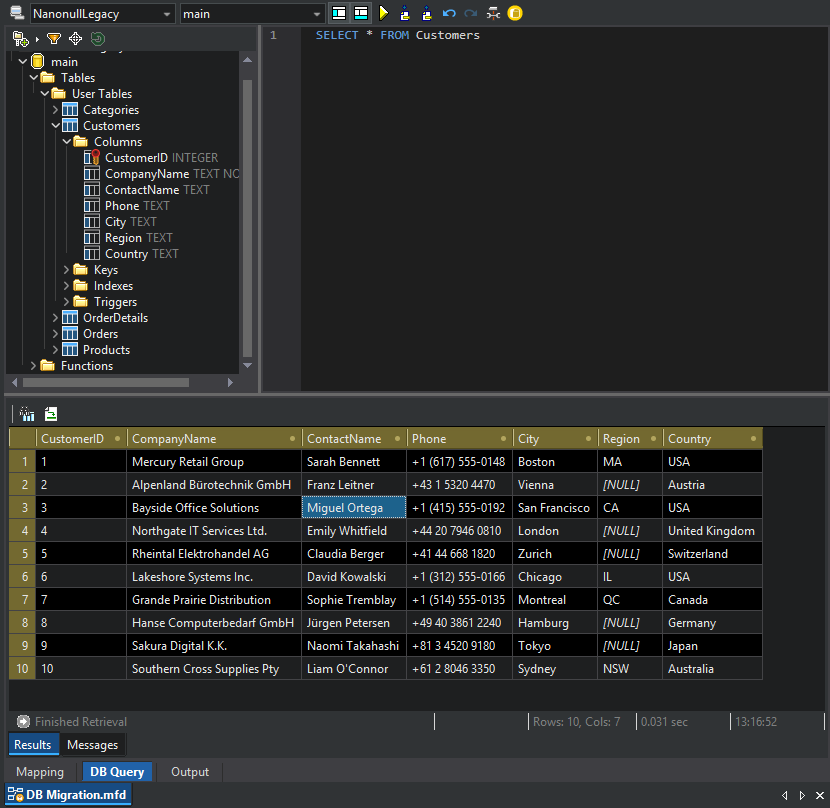
L’onglet Requête de base de données vous permet d’exécuter des requêtes SQL sur la base de données source ou cible depuis MapForce, grâce à un éditeur SQL complet. Cette fonctionnalité est utile pour inspecter les données source avant de concevoir le mappage et pour vérifier les résultats dans la base de données cible une fois la migration lancée.
Trier les composants d'entrée de base de données
Pour les migrations nécessitant que les données d’entrée soient classées dans un ordre particulier, le composant SQL-WHERE/ORDER offre des options supplémentaires de tri et de filtrage pour les composants d’entrée de base de données.
Une fois le mappage de migration conçu et testé dans MapForce, Altova MapForce Server offre une automatisation hautement performante, pouvant être lancée depuis la ligne de commande, par programmation via une API, ou sous forme d’étape de tâche gérée par FlowForce Server en fonction de déclencheurs et de planifications définis.
MapForce Server inclut le traitement parallèle et le multithreading, l’insertion SQL en masse, ainsi qu’une prise en charge multiplateforme ; ainsi, les migrations volumineuses et les chargements répétés s’exécutent plus rapidement qu’ils ne le feraient en mode interactif. Dans le cas d’une migration par étapes où les mêmes tables sont déplacées à plusieurs reprises jusqu’au basculement, cela transforme un mappage ponctuel en une opération planifiée et reproductible.