Contexte de priorité
Le contexte de priorité vous permet de déterminer quelle entrée d'une fonction définit le contexte actuel lors de l'exécution du mappage. En fonction de la structure du mappage, vous pouvez définir un contexte prioritaire pour modifier l’ordre dans lequel les valeurs sont traitées et déterminer quelles données sources restent disponibles dans le contexte actuel.
Pour définir un contexte prioritaire pour une fonction, cliquez avec le bouton droit sur un connecteur d’entrée de la fonction et sélectionnez Contexte de priorité dans le menu contextuel. Le connecteur d’entrée désigné comme contexte prioritaire est alors entouré.
Cas 1 : Contrôle de l'ordre des combinaisons générées (séquences)
Lorsque plusieurs entrées de fonction reçoivent des séquences, le contexte de priorité détermine l'ordre dans lequel les combinaisons de sortie sont générées.
Traitement sans contexte de priorité
Dans le mappage ci-dessous, la fonction concat reçoit deux entrées. Chaque entrée de fonction est une séquence générée par la fonction generate-sequence. Si des séquences sont connectées à plusieurs entrées de fonction, le mappage génère le produit cartésien des séquences d'entrée.
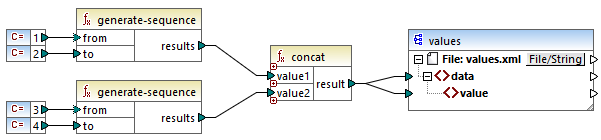
Par défaut, MapForce traite la première entrée de fonction avant la seconde. En conséquence, MapForce combine les valeurs comme suit :
<data> |
Traitement avec contexte de priorité
Le schéma ci-dessous montre que le contexte de priorité a été défini sur le deuxième connecteur d’entrée de la fonction concat. Cela signifie que MapForce traite d’abord la deuxième séquence d’entrée.
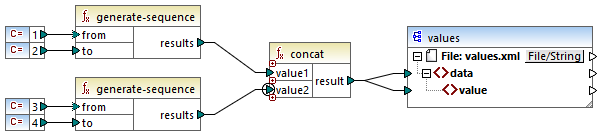
Ainsi, le contexte de priorité ne modifie que l’ordre dans lequel les combinaisons sont générées. Il ne modifie pas les combinaisons elles-mêmes. Le résultat est présenté ci-dessous.
<data> |
Cas 2 : Gestion du contexte actuel lors de la combinaison de données provenant de plusieurs sources
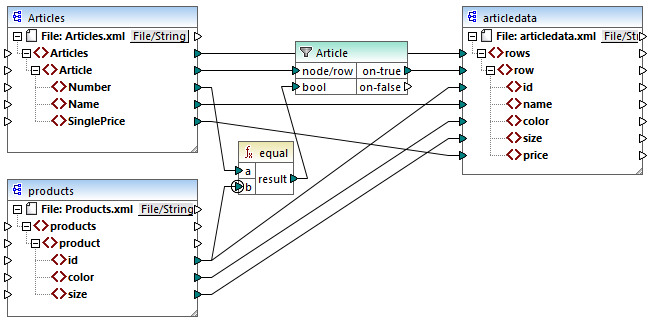
L'objectif du mappage ci-dessous est de copier les données du fichier Articles.xml dans un nouveau fichier XML doté d'un schéma différent, articledata.xml. Le mappage recherche les détails de chaque article dans le fichier Products.xml et les associe à l'enregistrement d'article correspondant.
Le contenu des fichiers Articles.xml et Products.xml est présenté ci-dessous.
<Articles> <Number>1</Number> <Name>T-Shirt</Name> <SinglePrice>25</SinglePrice> </Article> <Article> <Number>2</Number> <Name>Socks</Name> <SinglePrice>2,30</SinglePrice> </Article> <Article> <Number>3</Number> <Name>Jacket</Name> <SinglePrice>57,50</SinglePrice> </Article> |
Articles.xml
<products> <id>1</id> <color>red</color> <size>10</size> </product> <product> <id>2</id> <color>blue</color> <size>20</size> </product> |
Products.xml
Chaque enregistrement du fichier Articles.xml possède un Number, et chaque enregistrement du fichier Products.xml possède un id. La fonction equal vérifie si le numéro d'article et l'identifiant du produit sont identiques. Le résultat est ensuite transmis en entrée au filtre. Si la condition est true, les valeurs des éléments Name, SinglePrice, id, color et size sont copiées vers la cible.
Le contexte de priorité est défini sur le deuxième paramètre d’entrée de la fonction equal. Cela se traduit par la logique de mappage suivante :
•Pour chaque product, MapForce définit le produit actuel comme contexte pour la fonction equal.
•La priorité étant donnée aux données fournies par le fichier Products.xml, une nouvelle row de destination est créée pour chaque product qui satisfait la condition du filtre.
•Pour chaque Article, MapForce évalue la fonction equal dans le contexte du produit actuel. Si la condition de filtrage est true, l'article correspondant et les détails du produit sont mappés vers la cible.
•Les éléments Articles et rows étant connectés, le mappage remonte la connexion jusqu'à un article spécifique à chaque itération et ne copie que les détails de cet article vers la cible.
Le résultat est présenté ci-dessous.
<rows> <row> |
Absence de contexte de priorité
Si aucun contexte de priorité n’est défini pour la fonction equal, MapForce traite le mappage comme suit :
•Pour chaque Article, MapForce définit l’article actuel comme contexte pour la fonction equal.
•Chaque product est évalué dans le contexte de l’Article actuel.
•Le filtre compare l’Article actuel à chaque product. Si la condition du filtre est true, une row cible est créée.
•Comme l’élément product n’est connecté à aucun nœud cible, MapForce ne peut pas lire les détails d’un produit spécifique et intègre donc chaque produit dans le contexte actuel. En conséquence, chaque ligne cible contient les éléments id, size et color de tous les produits (dans Products.xml) qui satisfont à la condition du filtre.
Le résultat est présenté ci-dessous :
<rows> <row> |
Utilisation d'une variable à la place du contexte de priorité
Au lieu du contexte de priorité, vous pouvez utiliser une variable intermédiaire (le composant comportant le nœud compute-when ci-dessous) pour placer chaque article et chaque produit répondant aux conditions du filtre dans le même contexte. Les variables vous permettent de stocker temporairement des données et de modifier le contexte si nécessaire.
Nous avons modifié notre mappage en ajoutant une variable dont le schéma est identique à celui du composant cible (voir la capture d’écran ci-dessous).
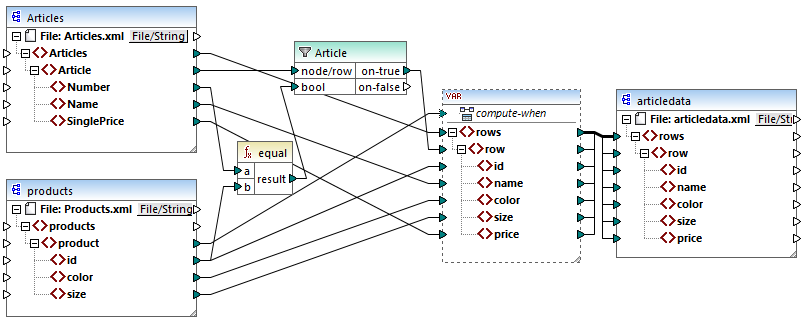
La logique du mappage modifié est la suivante :
•l’exécution commence au niveau du nœud racine cible.
•Avant de copier les données vers la cible, le mappage collecte les données dans la variable.
•La connexion entre l’élément product et le nœud compute-when entraîne le calcul de la variable dans le contexte de chaque product.
•La condition de filtrage est ainsi vérifiée dans le contexte de chaque product. Si la condition est true, la variable est renseignée avec les données correspondantes issues des deux fichiers sources. Ces données sont ensuite transmises à la cible.